2026年9月25日
GoblinStore 与 S3 Express:每次只传输一个对象
一台 Dell R820、机械硬盘、Graviton4 客户端,以及相同 590 个对象的可复现比较。
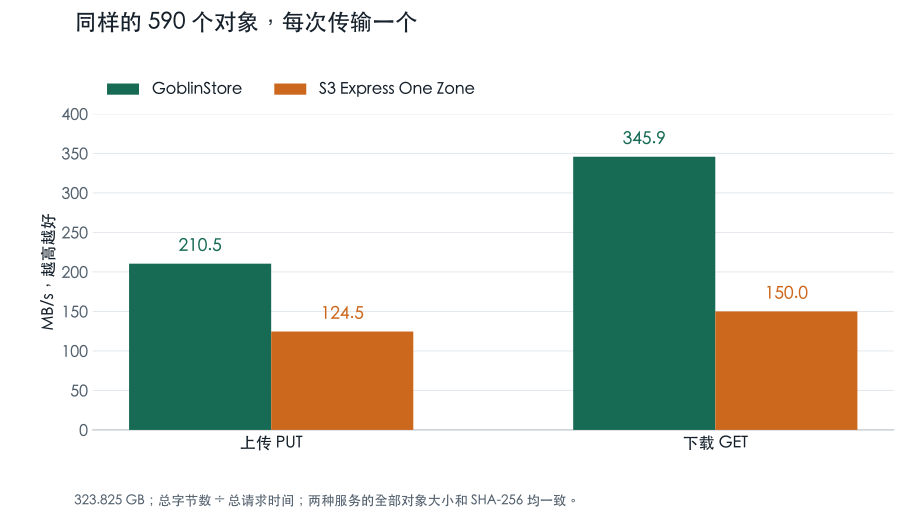
传输相同的 590 个对象、共 323.825 GB 数据时,GoblinStore 的上传速度为 210.5 MB/s,下载速度为 345.9 MB/s。S3 Express One Zone 的上传速度为 124.5 MB/s,下载速度为 150.0 MB/s。读取首字节时间的中位数分别是 GoblinStore 的 2.270 ms 和 S3 Express 的 4.453 ms。
在本次测量的配置下,GoblinStore 的上传吞吐量为对方的 1.69 倍,下载吞吐量为 2.31 倍,读取 TTFB 中位数降低了 49.0%。它的服务器是一台使用机械硬盘的 Dell PowerEdge R820。
这里测量的是两个实际部署的配置,客户端和网络路径各不相同。结果说明这些配置在串行工作负载下实际提供了什么性能。比拼最大总吞吐量就有点傻了:我地下室里的一台 R820,不过是 Amazon 挡风玻璃上的一只小虫。这项研究的第一部分,测量的是每次只传输一个对象时,两种配置各自能提供什么性能。
测试数据集采用 Google 在 2020 年 2 月发布的英语二元词组语料,保持其原始压缩形式。两种服务都传输了完整语料:589 个 gzip 分片和一个小型计数文件,总计 323,824,707,848 字节,即 323.825 GB。
两种服务全部 590 个对象的大小以及上传记录中的 SHA-256 摘要均一致。每次 S3 下载都通过了 SHA-256 校验,GoblinStore 下载得到的 MD5 也与最初上传的 ETag 一致。这项比较覆盖两种服务上传和下载的同一份完整数据集。
| 测量项目,相同的 590 个对象 | GoblinStore | S3 Express One Zone |
|---|---|---|
| 上传吞吐量 | 210.5 MB/s | 124.5 MB/s |
| 下载吞吐量 | 345.9 MB/s | 150.0 MB/s |
| 读取 TTFB 中位数 | 2.270 ms | 4.453 ms |
| 读取 TTFB 第 95 百分位 | 2.579 ms | 5.431 ms |
| PUT 首次响应时间中位数 | 2.622 s | 4.447 s |
这里的吞吐量是总字节数除以测得的总传输时间。MB 和 GB 使用十进制;标为 MiB 或 GiB 的内存容量使用二进制。百分位数按每个请求计算,第 95 百分位采用最近秩法。每个阶段的 590 次传输全部成功,每次下载都通过了校验。S3 运行还删除了全部 590 个测试对象,没有重试或错误。
完整 S3 运行复现了先前 50 对象测试的吞吐量:上传分别为 124.54 和 124.47 MB/s,下载分别为 150.04 和 150.03 MB/s。若把两份 S3 记录都限定到同样的 50 个对象,两种传输速率的变化均小于 0.02%。在本文报告的精度下,将测试扩展到完整语料并未改变 S3 的吞吐量结果。
AWS 一侧使用的是 S3 Express One Zone,即其低延迟、单可用区存储类别,桶类型为 directory bucket(目录桶)。桶和所有 EC2 客户端都位于 us-east-2,可用区 ID 为 use2-az1。AWS 建议将计算实例与目录桶放在同一个可用区,本次测试采用的正是这种安排。
每台 EC2 客户端都是 c8gn.xlarge,具有四个 Graviton4 vCPU、8 GiB 内存和 ENA 网卡。AWS 的实例规格列出了该型号的 12.5 Gbit/s 基准网络带宽和 40 Gbit/s 突发带宽。这是实例规格,并不意味着单个 S3 请求能达到 40 Gbit/s。AWS 另行说明,普通情况下,不在同一个集群置放群组内的单流带宽限制为 5 Gbit/s,文档也列出了提高该限制的方法。
完整 S3 运行记录于 2026 年 9 月 26 日,使用桶所在可用区中的另一台 Graviton4 c8gn.xlarge。它与 50 对象运行使用相同的基准程序源码、libcurl 版本、TLS 库和串行传输方法。
有限的 iperf3 3.20 检查使用了同一可用区中的另外两台 c8gn.xlarge 实例:每个方向只用一条 TCP 流,运行十秒,两个方向依次测试。
| EC2 私网路径 | 接收端吞吐量 | 重传次数 |
|---|---|---|
| 客户端 A → 客户端 B | 4.9646 Gbit/s | 0 |
| 客户端 B → 客户端 A | 4.9650 Gbit/s | 0 |
两台实例的 ENA 带宽、包速率、连接跟踪和链路本地流量超限计数器始终为零。在这些检查中,主机通过一条 TCP 流就能传输约 621 MB/s。因此,普遍存在的 1 Gbit/s 实例上限无法解释观察到的 S3 上传速度。
iperf 测量的是 TCP,无法定位 HTTPS 客户端或 S3 内部的限制因素。我也没有确定 S3 流量走的是 VPC 网关端点还是互联网网关,因为实例角色没有读取路由表的权限。证据支持的结论,是同可用区 EC2 客户端访问这个目录桶时实际得到的吞吐量。AWS 服务之间的网络路径,也是这一实际结果的一部分。
GoblinStore 的客户端是一台工作站,配有 AMD Ryzen Threadripper PRO 5995WX:64 个物理核心、128 个硬件线程、1 TiB 内存和 10 GbE 网络连接。基准程序使用一个客户端工作线程。客户端将服务域名解析到服务器的局域网地址,同时保留 HTTPS 证书名称及 TLS 校验。
服务器是 Dell PowerEdge R820,配有四颗 Xeon E5-4657L v2,共 48 个物理核心、96 个硬件线程,以及 512 GiB 安装内存。这些处理器采用较多核心、较低频率的配置:Intel 的规格列出了每颗 12 个核心、2.40 GHz 基础频率和最高 2.90 GHz 睿频。
我通过 CPU 亲和性和内存绑定,将 GoblinStore 限制在 NUMA 叶节点 1(Linux 节点 1)。这是机器四个 NUMA 叶节点中的一个,提供 12 个物理核心及其 24 个硬件线程,配置了 12 个服务器工作线程,并在同一叶节点上分配了 112 GiB 锁定内存区。
| 组件 | NUMA 叶节点 | 连接位置 |
|---|---|---|
| GoblinStore 工作线程和内存 | 1 | CPU 亲和性和内存绑定 |
| PERC H710 及其 SAS RAID6 阵列 | 0 | PCI 0000:02:00.0 |
面向基准客户端的 10 GbE 端口 eno1 |
0 | PCI 0000:01:00.0 |
第二个 10 GbE 端口 eno2 |
0 | PCI 0000:01:00.1 |
这台 R820 还承载其他实时业务。叶节点 1 是分配给 GoblinStore 的资源;磁盘控制器和以太网端口连接在叶节点 0,因此 GoblinStore 的磁盘和网络 I/O 都要经过处理器插槽间的互连。
9 月 25 日 22:30 UTC 的一次 30 秒后台负载采样结束时,一分钟、五分钟和十五分钟的平均负载分别为 2.14、2.38 和 2.43。面向基准客户端的端口平均接收约 1.0 Mbit/s、发送约 0.05 Mbit/s;三个十秒区间内的接收速率介于 0.90 至 1.11 Mbit/s。第二个 10 GbE 端口在采样期间没有流量。这些是当前后台负载的测量值,与基准运行分开采集。
nginx 负责 HTTPS 终止,请求缓冲、响应缓冲和代理缓存均关闭。完整读取运行使用了 64 KiB 代理缓冲区。
这些是较早的 Ivy Bridge 时代 Xeon。实际 CPU 标志包含 AES-NI 和 AVX,但没有 SHA 扩展。Intel 为这款处理器列出了 AVX 和 AES-NI。SHA-256 和 MD5 通过 OpenSSL 以软件方式计算,没有专门的哈希卸载。用于 TLS 的 AES 加速是另一回事,并不等于处理器具备 SHA 加速。
存储由十六块 300 GB、15,000 RPM、2.5 英寸 SAS 机械硬盘组成一个 RAID6 阵列,连接到 Dell PERC H710,条带单元大小为 64 KiB。阵列提供 4.192 TB 容量,上层使用 LVM 和 XFS。十六块硬盘的 SAS 链路均协商为 6 Gbit/s。具体型号如下:
| 硬盘型号 | 数量 |
|---|---|
Seagate ST300MP0026 |
2 |
Seagate ST300MP0005 |
5 |
Seagate ST9300653SS |
1 |
HGST HUC156030CSS204 |
2 |
Toshiba AL13SXB30EN |
6 |
Dell 的硬盘规格将这五种型号均列为 15K SAS 硬盘。
H710 配有 512 MB DDR3 缓存,并由电池和闪存提供保护:断电时,电池供电将缓存数据转存到非易失性闪存,具体机制见 Dell 控制器手册。控制器报告 382 MB 固件缓存,备用电池状态为 Optimal(正常)。控制器启用了 WriteBack(回写),单个硬盘的写缓存则被禁用。
323.825 GB 的工作负载在这里很重要。它超过控制器板载内存的 600 倍。控制器不可能靠接收几百 GB 数据,再全部留在 512 MB 缓存里来解释整个运行。持续写入要求它不断把数据写到磁盘。回写仍会影响请求何时得到确认;本次基准并没有验证断电持久性,也没有确定每个字节何时真正写到盘片。
我在设计 GoblinStore 时,将对象头部放在内存中,并使用 O_DIRECT 读取磁盘尾部。直接 I/O 绕过 Linux 页缓存;后端磁盘和控制器缓存仍在读取路径中。
本次基准将内存头部配置为每个对象 1 MiB。整份语料的头部数据约为 589 MiB,再加上那个小型计数对象。112 GiB 内存区提供分配容量;每个大对象的其余部分从磁盘尾部读取。
内存头部降低了首字节延迟。吞吐量测量覆盖完整对象,包括其位于磁盘上的尾部。
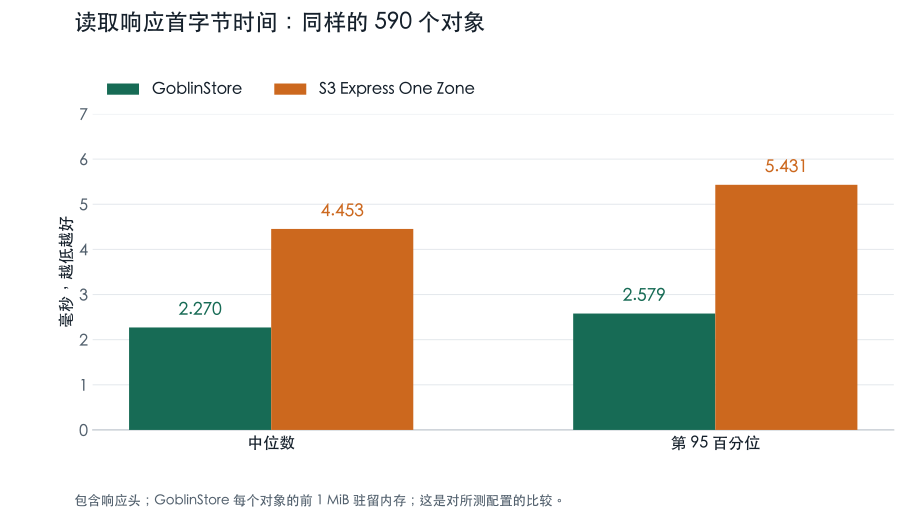
所有客户端均使用 libcurl 8.22.0 和 OpenSSL 3.5.5,记录中的 HTTP 版本为 HTTP/1.1。传输时间来自 libcurl 自身的计数器。TTFB 计数器测量收到首个响应字节的时间,包括响应头,以及必要时建立连接的时间。它并不专指首个响应体字节。
对于 PUT,首个响应通常要等对象上传完成后才到达。因此表中的 2.622 s 和 4.447 s 包含发送数据的时间。它们是有用的请求、响应测量,但不应被当作存储查询延迟。上图绘制的毫秒级指标是 GET TTFB。
GoblinStore 运行使用独立的上传、下载客户端,数据缓冲区为 1 GiB。AWS 运行使用一体化客户端和预先触页的 2 GiB 缓冲区,每次上传一个完整对象。全部 590 个对象上传完毕后,再逐个从 S3 GET、校验并删除。没有分段上传、并行范围读取,也没有同时进行多个对象的数据传输。
数据准备和上传哈希计算都在 PUT 计时开始前完成,下载哈希计算则在 GET 计时结束后进行。CSV 写入、删除以及 S3 Express 会话刷新不计入相应的数据传输时间。TLS、请求签名和客户端内存复制的成本仍然包含在内。两类客户端都允许连接复用;CSV 记录了实际新建连接数:590 次 S3 PUT 共新建 345 条连接,其 GET 阶段新建十条;GoblinStore 的两个完整阶段各新建一条。
AWS 建议对较大的 S3 Express 对象使用并发连接,以获得最高吞吐量。本次工作负载有意测量每次只传输一个对象能得到什么性能。它不是压力测试,也不比较产品的持久性保证、可用性、最高请求率,或大量客户端同时访问时的表现。
GoblinStore 在并发下的吞吐量
研究的第二部分关注 GoblinStore 的并发增加时,总吞吐量如何上升,以及每个活动传输的速度如何下降。读取和写入分别测试,每个点都覆盖完整的 590 个对象、323.825 GB 语料,每份记录采用最新的一次运行。图中序列截至使用 12 个工作线程的运行。
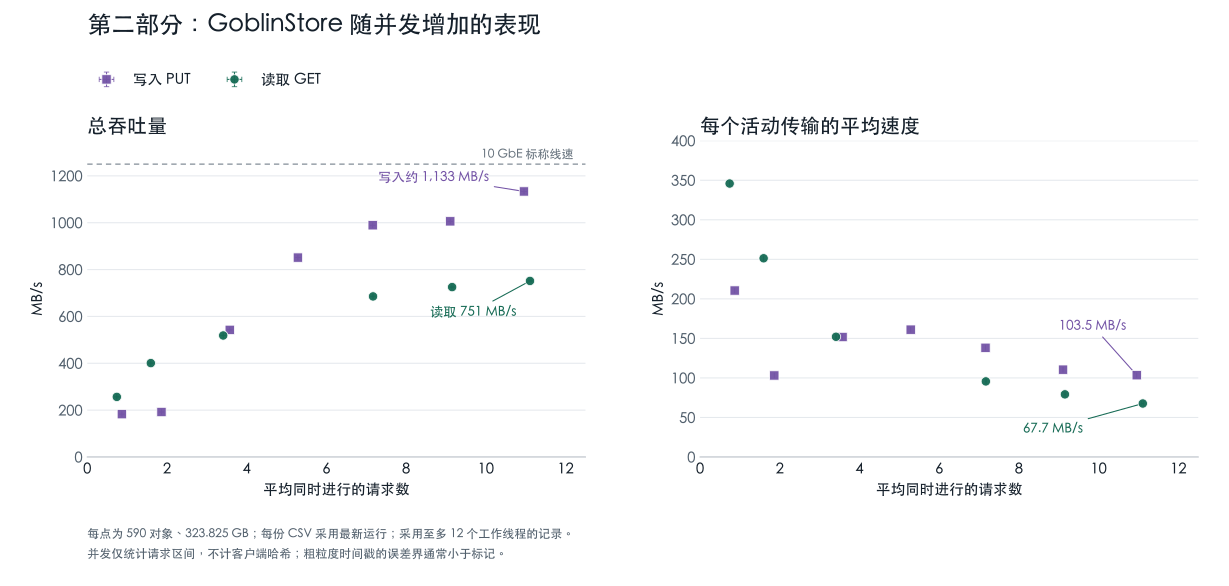
横轴是根据请求开始和结束时间计算的平均同时进行的请求数。对每次运行,我将所有请求的持续时间相加,再除以从首个请求开始到最后一个请求完成的经过时间。这就是未完成请求数的时间平均值。工作线程在加载文件或计算响应哈希时,不计为活动请求。这段经过时间内的空闲间隔仍计入分母,因此单工作线程运行的平均并发数也可能小于一。
总吞吐量是总字节数除以上述经过时间。每个活动传输的平均吞吐量,是总字节数除以所有请求持续时间之和。它衡量每个未完成传输分得的带宽;物理网络连接仍为 10 GbE。客户端的空闲间隔会降低这里的总吞吐量,而第一部分仅按请求时间计算的速率不包含这些间隔。
并发上传记录具有微秒精度的明确开始、结束时间戳。下载记录和最初的单工作线程上传记录只把开始时间记录到整秒,因此用开始时间加上 libcurl 的请求持续时间来重建结束时间。这些记录的平均并发数和总吞吐量是估计值;对于这些运行的时间跨度,时间戳分辨率带来的不确定性小于 0.25%。所有请求区间都不包含哈希计算时间。
比较图中上传序列的两个端点,平均并发数从 0.87 增至 10.96,总吞吐量从 182.8 升至 1,133.5 MB/s,高端点相当于 9.07 Gbit/s。每个活动上传的平均吞吐量则从 210.5 降至 103.5 MB/s。
读取的平均并发数从 0.74 增至 11.11,总吞吐量从 256.5 升至 751.5 MB/s,相当于 6.01 Gbit/s;每个活动下载的平均吞吐量从 345.9 降至 67.7 MB/s。同时传输更多对象,可以更充分地使用服务器的总容量,但每个传输分得的份额会缩小。这些是共享服务器在分别进行的运行中表现出的工作点;记录并未将并发的影响与后台负载或配置变化的影响分离。
并发研究补充归档提供原始记录、运行选择规则、计算代码和两幅图表,另附 SHA-256 校验文件。
客户端传输能力:本地 nginx 对照测试
这项对照测试测量的是客户端向同一台机器上的内存 nginx 端点传输数据的能力,用于确认存储比较中客户端 CPU 和软件的性能余量。这里的速率来自本地 nginx 传输,不是 S3 性能测量。
对照测试使用了 Threadripper PRO 5995WX 工作站,以及用于完整 S3 运行的那台 Graviton4 c8gn.xlarge 实例。每台机器都通过回环接口访问本机的 nginx 1.28.3 端点,客户端和 nginx 绑定到不同的物理核心。对象及 nginx 上传临时文件都存放在内存中的 tmpfs 上。数据传输始终位于各自机器的本地网络栈内。
每种协议都一次只传输一个 512 MiB 对象,先运行一组 PUT/GET 预热,再测量五组。对照测试复用了一体化基准程序的传输代码,包括内存复制回调和请求签名,使用 libcurl 8.22.0 和 OpenSSL 3.5.5。HTTPS 使用 TLS 1.3 和 AES-256-GCM,并启用证书验证。每次下载都通过了 SHA-256 校验。
| 客户端 CPU | 协议 | 上传至 nginx,MB/s | 上传 CPU 使用率 | 从 nginx 下载,MB/s | 下载 CPU 使用率 |
|---|---|---|---|---|---|
| Threadripper PRO 5995WX | HTTP | 1,757.6 | 71.1% | 5,316.2 | 99.4% |
| Threadripper PRO 5995WX | HTTPS | 1,136.6 | 76.5% | 1,028.9 | 92.0% |
Graviton4(c8gn.xlarge) |
HTTP | 3,074.7 | 42.8% | 9,597.4 | 99.1% |
Graviton4(c8gn.xlarge) |
HTTPS | 1,680.8 | 63.0% | 1,490.5 | 81.1% |
CPU 百分比以客户端的单个核心为基准,只覆盖计时传输区间。数据准备、校验和计算及 CSV 输出均在该区间之外。吞吐量为五次测量请求的总字节数除以传输时间之和;CPU 使用率为这些传输期间的客户端线程 CPU 时间之和,除以相应的经过时间之和。
访问本地 nginx 时,Graviton4 客户端的 HTTPS 上传和下载速率分别是访问 S3 Express 时所测速率的 13.5 倍和 9.9 倍。Threadripper 的 HTTPS 速率分别是完整语料 GoblinStore 比较中上传速率的 5.4 倍、下载速率的 3.0 倍。HTTPS 对照测试期间,nginx 使用了自身核心的 97.5–99.9%。两种客户端配置都展示了远高于存储测量所需的传输能力。
客户端余量补充归档包含对照测试源码、nginx 设置、构建和运行说明、原始传输及 CPU 测量记录和计算代码,另附 SHA-256 校验文件。
完整语料复现归档包含 C++ 客户端、S3 Express 会话辅助程序、所用 curl 版本的源码发布包、构建和运行说明、记录下来的 CSV、全部 590 个对象的清单、硬件与配置细节,以及重新生成表格和图表的脚本。另有独立的 SHA-256 校验文件。归档提供的是基准客户端代码;如需访问本次测量的 GoblinStore 服务,可以通过本站联系信息进行安排。复现局域网测量需要安排等效的局域网路径,而不是测量一条无关的互联网路径。
AWS 服务条款第 1.8 条允许基准测试,要求在公开结果中提供复现所需的信息,并向 AWS 披露这些信息,同时允许 AWS 对客户的产品或服务进行基准测试并公开结果。欢迎 Amazon 测试 GoblinStore,并发表测量所得。源码、输入清单、测量记录和计算方法都已为此提供。